 VoiceAPI
Часто задаваемые вопросы
Что такое API синтеза речи?
Это облачный API, принимающий текст и возвращающий аудиофайл. Вы отправляете JSON-запрос по POST-эндпоинту, указывая модель, голос, язык и формат. Интеграция проста: достаточно изменить base_url в OpenAI SDK или использовать HTTP-запросы с вашим API-ключом. Сервис генерирует речь и возвращает готовый файл в запрошенном формате (mp3, wav, opus, flac, pcm).
Как работает текст в речь онлайн?
Вы отправляете JSON-запрос с текстом (до 4096 символов) на эндпоинт /v1/audio/speech. Укажите модель (tts-1 или tts-1-hd), голос и формат ответа. Сервис вернет сгенерированный аудиофайл. Если текст длиннее, его нужно разбить на части, синтезировать отдельно и склеить.
Можно ли использовать API для чат-ботов?
Да, API идеально подходит для голосовых помощников и чат-ботов. Вы отправляете текст бота через API и получаете аудиофайл для воспроизведения пользователю. Поддерживается 23 языка, есть настройка скорости от 0.25 до 4.0. Это обеспечивает простую интеграцию без сложных настроек для автоматической озвучки.
Какие языки поддерживает синтезатор?
Синтезатор поддерживает 23 языка: от английского и русского до арабского, хинди и суахили. Любой голос может произносить любой из этих языков. Если язык не указан явно, система пытается определить его по скрипту, но для неанглийских текстов на латинице рекомендуется задавать язык явно.
Нужен ли специальный софт для работы?
Нет, достаточно HTTP-клиента или библиотеки. Официального SDK нет, но работают стандартные OpenAI SDK при смене base_url на https://api.playthanjai.com/v1. Можно использовать curl или любой язык с поддержкой HTTP. Мобильных SDK, плагинов для WordPress и расширений для браузера нет.
Как быстро генерируется аудиофайл?
Скорость генерации примерно равна реальному времени: около 25 символов текста в секунду аудио. Короткие фразы занимают несколько секунд. Запросы обрабатываются последовательно, поэтому при высокой нагрузке может возникнуть очередь. Для длинных текстов время зависит от их объема.
Можно ли настраивать скорость речи?
Да, параметр speed позволяет регулировать скорость от 0.25 до 4.0. Это полезно для адаптации речи под разные сценарии использования, например, для быстрых уведомлений или медленного повествования. Значение передается в JSON-теле запроса вместе с текстом и настройками голоса.
Какие форматы аудио поддерживаются?
API поддерживает пять форматов: mp3, wav, opus, flac и pcm. Вы выбираете нужный формат в поле response_format запроса. Это позволяет оптимизировать размер файла и совместимость с различными плеерами и системами воспроизведения в зависимости от требований вашего приложения.
Нужно ли платить за каждый запрос?
Оплата взимается за объем текста: $10 за 1 миллион символов. Проваленные запросы бесплатны, если синтез не удался, средства возвращаются. Баланс пополняется через USDT (TRC-20). Подписок или абонентской платы нет, вы платите только за фактическое использование.
Можно ли озвучивать длинные тексты?
Максимум 4096 символов за один запрос. Для длинных текстов необходимо разбить их на части, отправить каждый фрагмент отдельно и затем склеить полученные аудиофайлы. Это стандартный подход для работы с большими объемами текста через данный API без ограничений по длине.
Как выбрать подходящий голос?
Доступно 8 голосов: Aria, Nova, Luna, Sage (женские) и Felix, Milo, Atlas, Orion (мужские). Каждый имеет свой тембр: от спокойного до энергичного. Список голосов и их характеристики доступны через GET-запрос к эндпоинту /v1/voices. Выбирайте голос, соответствующий тону вашего продукта.
Есть ли лимиты на количество запросов?
Лимит составляет 60 запросов в минуту на один ключ API. До первого пополнения он ограничен 10 запросами в минуту. Запросы обрабатываются последовательно, поэтому при высокой нагрузке они могут ожидать в очереди. Это увеличивает время генерации аудио, но запросы не отклоняются автоматически при достижении предела.
Безопасно ли передавать текст по API?
Да, текст используется только для синтеза и не передается для обучения моделей. Сгенерированное аудио не сохраняется на серверах. Метаданные запросов (время, объем) хранятся только для биллинга. Данные защищены стандартными протоколами передачи, так как API работает через HTTPS.
Как интегрировать API в свой проект?
Получите API-ключ на странице /get-api-key/. Используйте POST-запрос к https://api.playthanjai.com/v1/audio/speech с заголовком Authorization: Bearer <ключ>. Укажите текст, голос и формат. Можно использовать OpenAI SDK, изменив base_url, или отправлять прямые HTTP-запросы из вашего кода.
Определение технологии
API синтеза речи — это облачный сервис, который преобразует текстовые данные в аудиофайлы через HTTP-запросы. Это технологический интерфейс для разработчиков, позволяющий интегрировать голосовую озвучку в приложения без необходимости создавать собственную инфраструктуру для обработки аудио.
Технология обеспечивает автоматизацию процессов генерации голоса, заменяя заранее записанные фрагменты динамически создаваемым аудио. Разработчики могут мгновенно получать звуковые файлы, адаптированные под задачи голосовых помощников и чат-ботов, экономя время на настройке мультимедийного контента.
Текст в речь онлайн
Сервис принимает текст длиной до 4096 символов и возвращает готовый аудиофайл в форматах MP3, WAV, OPUS, FLAC или PCM. Это универсальное решение, где ввод ограничивается количеством символов, что требует разбивки больших текстов на части для последующего объединения.
API для разработчиков
Интерфейс совместим с форматом запросов OpenAI, что позволяет использовать готовые SDK. Для подключения достаточно изменить базовый URL на https://api.playthanjai.com/v1 и передать API-ключ. Поддерживаются 8 предустановленных голосов и 23 языка.
Автоматизация озвучки
Используйте API для генерации ответов чат-ботов и голосовых уведомлений. Скорость генерации близка к реальному времени, а цена составляет $0.01 за 1000 символов, что делает интеграцию экономически эффективной для стартапов.
Технология позволяет автоматизировать озвучку длинных текстов без необходимости использовать заранее записанные фрагменты. Это делает интеграцию простой и масштабируемой для любых объемов данных.
Как работает синтез речи
API синтеза речи работает по принципу отправки текстовых данных на сервер для преобразования в аудио. Это простой и эффективный способ автоматизации озвучки, который подходит для интеграции в голосовых помощников и чат-ботов.
Отправка текста на сервер
Для начала работы вы отправляете POST-запрос на конечную точку API. В теле запроса передается текст, который необходимо озвучить. Максимальный объем текста составляет 4096 символов за один запрос, включая пробелы и знаки препинания. Если ваш текст длиннее, его следует разбить на части.
- Используйте POST-запрос к https://api.playthanjai.com/v1/audio/speech
- Формат данных — JSON с полем
inputдля текста - Лимит: 4096 символов на один запрос
Генерация аудиофайла
Сервер обрабатывает запрос, выбирая указанный голос и язык. Синтез происходит последовательно, поэтому при высокой нагрузке запросы могут стоять в очереди. Типичная скорость генерации составляет около 25 символов текста в секунду, что близко к реальному времени воспроизведения. Для коротких фраз может потребоваться несколько секунд на обработку.
- Доступные модели: tts-1 и tts-1-hd
- Скорость генерации: ~25 символов в секунду
- Возможна очередь при высокой нагрузке
Получение результата
После завершения синтеза вы получаете аудиофайл в выбранном формате (mp3, wav, opus, flac, pcm). Если синтез не удался, вы получите код ошибки, и за этот запрос средства не спишутся. Аудиофайл возвращается непосредственно в ответе, не сохраняясь на сервере для последующего использования.
- Поддерживаемые форматы: mp3, wav, opus, flac, pcm
- Неудачные запросы бесплатны
- Аудио не сохраняется на сервере
Применение в чат-ботах
API синтеза речи позволяет чат-ботам генерировать аудиоответы по запросу. Вместо статичного текста бот может озвучивать короткие фразы, используя голоса типа Aria или Felix. Это особенно полезно для голосовых помощников, где текст преобразуется в аудиофайл через POST-запрос к endpoint /v1/audio/speech.
Динамическая генерация речи снижает нагрузку на пользователя при чтении длинных сообщений. Интеграция VoiceAPI не требует сложной настройки: достаточно отправить JSON с текстом и получить готовый mp3 или wav файл. Боты могут использовать это для мультимедийных диалогов, предоставляя естественное звучание без предварительной записи.
Голосовые ответы бота
Каждый запрос к API преобразует текст в аудиофайл, который бот может воспроизвести сразу после получения. Поддерживаются форматы MP3, WAV, OPUS, FLAC и PCM. Голоса основаны на лицензированных записях LibriTTS-R, обеспечивая четкое звучание без необходимости загрузки внешних библиотек.
- Генерация аудио по HTTP-запросу
- Поддержка 8 предустановленных голосов
- Форматы MP3, WAV, OPUS, FLAC, PCM
Улучшение пользовательского опыта
Использование синтезированной речи делает взаимодействие с ботом более естественным. Пользователи могут слушать ответы, не отвлекаясь на экран. Скорость генерации составляет около 25 символов в секунду, что позволяет быстро получать ответы на короткие фразы.
Мультимедийные диалоги
Боты могут комбинировать текст и аудио в одном диалоге. API поддерживает 23 языка, включая английский, русский, китайский и испанский. Это позволяет создавать мультиязычные сценарии без дополнительных затрат на контент.
- Поддержка 23 языков
- Автоматическое определение языка
- Гибкая настройка скорости (0.25–4.0x)
Использование в голосовых помощниках
Голосовые помощники используют API синтеза речи для преобразования текста в аудиофайлы. Этот подход позволяет стартапам интегрировать озвучку в свои приложения без сложной инфраструктуры. Технология поддерживает 23 языка, что упрощает локализацию продуктов для разных рынков.
Озвучка команд управления
API обрабатывает короткие фразы за несколько секунд, что является приемлемой задержкой для большинства интерфейсов. При высокой нагрузке запросы могут стоять в очереди, но генерация остается предсказуемой.
Аудиоинструкции
Голос Sage отлично подходит для спокойных инструкций, а Atlas обеспечивает нейтральный тон для новостных обновлений. Эти варианты позволяют точно настроить звучание помощника под задачи без дополнительных настроек.
Голосовые уведомления
Для уведомлений можно использовать разные голоса в зависимости от контекста. API возвращает готовый аудиофайл, который сразу воспроизводится в приложении. Это избавляет от необходимости хранить файлы на сервере.
Технические требования
API синтеза речи использует стандартные HTTP-запросы для интеграции в приложения. Это позволяет разработчикам легко подключать озвучку к существующим сервисам без сложных настроек инфраструктуры.
Данные передаются в формате JSON, что упрощает парсинг ответов и обработку метаданных. Протокол поддерживает HTTPS для безопасной передачи ключей и текста.
HTTP протокол
Используется метод POST для отправки запросов на синтез. API возвращает аудиофайл непосредственно в теле ответа, без необходимости искать ссылки на файлы.
JSON формат данных
Запрос включает параметры модели, голоса, языка и текста в формате JSON. Ответ содержит бинарные данные аудио и метаданные запроса.
Поддержка HTTPS
Все соединения защищены протоколом HTTPS, что обеспечивает безопасность передачи API-ключа и конфиденциальных данных пользователей.
Интеграция с разными языками
API поддерживает 23 языка, включая английский, русский, китайский и арабский. Уникальная особенность системы — возможность использовать любой из 8 голосов (например, Aria или Felix) для озвучки текста на любом из доступных языков без ограничений.
Автоматическое определение языка по скрипту работает для латиницы (по умолчанию — английский). Для других языков латиницы или специфических сценариев рекомендуется явно указывать параметр language, чтобы избежать ошибок распознавания.
Поддержка 23 языков
Список включает арабский, китайский, датский, нидерландский, английский, финский, французский, немецкий, греческий, иврит, хинди, итальянский, японский, корейский, малайский, норвежский, польский, португальский, русский, испанский, суахили, шведский и турецкий. Любой голос способен воспроизвести все эти языки с одинаковым качеством.
- Арабский, Китайский, Датский, Нидерландский, Английский
- Финский, Французский, Немецкий, Греческий, Иврит
- Хинди, Итальянский, Японский, Корейский, Малайский
- Норвежский, Польский, Португальский, Русский, Испанский
- Суахили, Шведский, Турецкий
Автоопределение языка
Если параметр language не указан, система определяет язык по используемому алфавиту. Текст на кириллице распознается как русский, иероглифы — как китайский или японский. Текст на латинице по умолчанию считается английским.
Ручной выбор языка
Для точного результата в теле запроса укажите код языка (ISO 639-1). Это критично для текстов на латинице, не являющихся английскими (например, испанском или немецком), чтобы избежать озвучки акцентом английского голоса.
Преимущества API перед софтом
API синтеза речи заменяет локальное ПО, перенося вычислительную нагрузку на облако. Это избавляет от необходимости управлять серверами и лицензиями для каждой платформы. Разработчики получают готовый интерфейс для автоматизации озвучки голосовых помощников и чат-ботов без привязки к конкретному оборудованию.
Текст отправляется на сервер, где обрабатывается в очереди и возвращается в виде аудиофайла. Такой подход позволяет быстро масштабировать проект: при росте нагрузки запросы ставятся в очередь и обрабатываются последовательно, сохраняя предсказуемость результата без сложных настроек инфраструктуры.
Гибкость интеграции
API использует стандартный HTTP-протокол и JSON-формат данных. Интеграция с голосовыми помощниками и ботами занимает минимум времени, так как запросы можно отправлять из любой среды, поддерживающей сетевые соединения.
Отсутствие необходимости установки дополнительного ПО на клиентские устройства упрощает поддержку продукта. Разработчики фокусируются на логике диалога, а не на управлении процессами синтеза.
- Стандартный HTTP POST-запрос
- JSON-формат тела запроса
- Поддержка HTTPS для безопасности
Масштабируемость
Облачная архитектура позволяет обрабатывать растущий объем запросов без изменения клиентского кода. При нагрузке запросы ставятся в очередь и обрабатываются последовательно, что предотвращает потерю данных.
Лимит в 60 запросов в минуту на ключ позволяет начать разработку без предварительных инвестиций в инфраструктуру. При росте трафика можно просто увеличить лимиты, не меняя архитектуру приложения.
- Обработка запросов в очереди
- Последовательная генерация аудио
- Отсутствие ограничений по количеству клиентов
Кроссплатформенность
API работает на любом устройстве или сервере, способном отправлять HTTP-запросы. Это позволяет использовать один голосовой движок для Android, iOS, веб-приложений и серверных бэкендов.
Использование стандартных SDK (например, OpenAI SDK с изменением base_url) ускоряет разработку. Не нужно писать отдельные модули синтеза для каждой платформы.
Поддержка 23 языков в одном API позволяет унифицировать озвучку мультиязычных голосовых помощников без необходимости подключать дополнительные языковые пакеты.
- Работа на любых ОС и серверах
- Единый интерфейс для всех платформ
- Поддержка популярных SDK
Примеры использования кода
Для интеграции VoiceAPI в ботов и голосовые помощники достаточно стандартных HTTP-запросов. Поддержка OpenAI SDK упрощает работу: SDK для Python и JavaScript работают напрямую, если изменить базовый URL на https://api.playthanjai.com/v1. Это позволяет использовать знакомые инструменты без создания кастомных клиентов.
Ниже приведены примеры отправки текста в синтезатор. Каждый запрос возвращает аудиофайл в указанном формате. Для обработки больших текстов используйте логику разбиения на части по 4096 символов и последующего объединения аудио.
Код на Python
Используйте официальный пакет openai. Укажите базовый URL вашего API и токен авторизации.
```python import openai client = openai.OpenAI( base_url="https://api.playthanjai.com/v1", api_key="tts-your-api-key" ) response = client.audio.speech.create( model="tts-1", voice="nova", input="Привет! Это тестовый голосовой помощник.", response_format="mp3" ) response.stream_to_file("output.mp3") ```
Код на JavaScript
Используйте пакет openai для Node.js. Настройте базовый URL и ключ API.
```javascript import OpenAI from 'openai'; const openai = new OpenAI({ baseURL: 'https://api.playthanjai.com/v1', apiKey: 'tts-your-api-key' }); const response = await openai.audio.speech.create({ model: 'tts-1', voice: 'nova', input: 'Привет! Это тестовый голосовой помощник.', response_format: 'mp3' }); const buffer = Buffer.from(await response.arrayBuffer()); ```
Пример cURL запроса
Отправьте запрос POST на эндпоинт /v1/audio/speech. Заголовки должны содержать авторизацию и тип контента.
```bash curl https://api.playthanjai.com/v1/audio/speech \ -H "Authorization: Bearer tts-your-api-key" \ -H "Content-Type: application/json" \ -d '{ "model": "tts-1", "voice": "nova", "input": "Привет! Это тестовый голосовой помощник.", "response_format": "mp3" }' \ --output output.mp3 ```
Настройка качества аудио
Формат вывода выбирается между MP3, WAV, OPUS, FLAC и PCM в зависимости от требований клиента. API возвращает готовый аудиофайл в указанном формате, обеспечивая баланс между качеством звука и размером файла.
Выбор формата файла
Доступные форматы: mp3, wav, opus, flac, pcm. Выбор зависит от целевой платформы и требований к объему данных.
Качество MP3 и WAV
MP3 обеспечивает сжатие с потерями, идеален для веба. WAV сохраняет исходное качество без сжатия, что важно для дальнейшей обработки. Оба формата поддерживаются нативно.
Оптимизация под нагрузку
При высокой нагрузке используйте сжатые форматы, такие как MP3 или OPUS, чтобы снизить трафик. Это критично для мобильных приложений и ограниченных соединений.
Контроль скорости речи
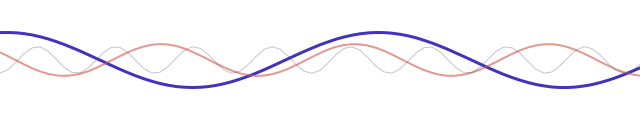
API синтеза речи позволяет точно контролировать темп произношения в диапазоне от 0.25 до 4.0. Значение 0.25 замедляет речь в четыре раза, а 4.0 — ускоряет её в четыре раза. Это даёт разработчикам гибкий инструмент для адаптации аудиоконтента под конкретные задачи без необходимости предварительной обработки аудиофайлов.
Ускорение и замедление
Параметр speed в запросе принимает значения от 0.25 до 4.0. Это позволяет изменять темп генерации в реальном времени. Например, значение 1.0 соответствует стандартной скорости, а 2.0 удваивает её. Диапазон охватывает как очень медленное, так и ускоренное произношение.
Настройка под задачу
Для голосовых помощников оптимальной часто является скорость 1.0–1.5, обеспечивающая естественный ритм. В чат-ботах, передающих технические инструкции, ускорение до 2.0–3.0 сокращает время ожидания ответа пользователя. Для медленного чтения или обучения можно использовать значения ближе к 0.25.
Влияние на восприятие
Скорость напрямую влияет на разборчивость речи. Слишком быстрое произношение может затруднить понимание сложных терминов, особенно в многоязычных сценариях. Медленная речь улучшает восприятие, но увеличивает время генерации аудио. Рекомендуется тестировать разные значения для каждой модели голоса и языка.
Безопасность данных
API синтеза речи обеспечивает защиту данных на всех этапах обработки. Передача текста и полученных аудиофайлов происходит по защищённому протоколу HTTPS, что исключает возможность перехвата информации при передаче между вашим приложением и серверами VoiceAPI. Это критически важно для голосовых помощников и чат-ботов, где контекст диалога может быть чувствителен.
Надёжность системы строится на прозрачном отношении к данным: входной текст используется исключительно для генерации аудио и не передается в базы данных для обучения моделей. Такая архитектура позволяет стартапам интегрировать TTS без риска нежелательного использования исходных данных пользователей.
Шифрование передачи данных
Все запросы к API и ответные потоки аудио передаются через защищённое соединение HTTPS. Это гарантирует целостность и конфиденциальность данных при обмене между вашим клиентом и облачным API.
- Протокол HTTPS обеспечивает шифрование в канале связи.
- Поддержка работает с официальными SDK и plain HTTP запросами.
Хранение метаданных
Для корректного биллинга система сохраняет метаданные запросов: время, количество символов и статус выполнения. Эти данные используются только для расчёта стоимости и не содержат текста озвучки.
Входной текст используется исключительно для генерации аудио и не передается в базы данных для обучения моделей, что соответствует принципам приватности.
Удаление аудио
Сгенерированный аудиофайл возвращается в ответе на запрос и не сохраняется на серверах VoiceAPI после отправки клиенту. Это означает, что мы не храним результат синтеза, снижая риски доступа к вашим контентным данным.
Масштабирование проекта
API синтеза речи предназначен для автоматизации озвучки текстов в голосовых помощниках и чат-ботах. Технология позволяет отправлять текст на сервер и получать готовый аудиофайл через простой HTTP-запрос, что обеспечивает быструю интеграцию без сложных настроек.
Обработка больших объемов
Для длинных текстов рекомендуется разбивать их на части до 4096 символов и последовательно объединять полученные аудиофайлы. Типичная скорость синтеза составляет около 25 символов в секунду, что соответствует реальному времени воспроизведения, а короткие фразы генерируются за несколько секунд.
Очереди запросов
Запросы обрабатываются последовательно, поэтому при высокой нагрузке новые запросы могут ожидать своей очереди. При превышении лимита новые запросы будут ожидать своей очереди или возвращать ошибку, что следует учитывать при планировании пиковых нагрузок.
Лимиты API
Доступно 60 запросов в минуту на ключ (10 запросов в минуту до первого пополнения). Это ограничение позволяет легко масштабировать проект, постепенно увеличивая объем генерируемого аудио по мере роста аудитории вашего продукта.
Послушайте 8 голосов
Каждый образец ниже сгенерирован этим API из одного и того же предложения. Голосовые помощники и чат-боты помогают стартапам автоматизировать рутинные задачи и улучшать клиентский опыт.


23 языка
Любой голос может говорить на любом из этих языков.
Источники и дополнительные материалы
- Wikipedia
- openai-node on GitHub
- ISO 639 language codes
- LibriTTS-R corpus (OpenSLR 141)
- LibriTTS-R paper (arXiv 2305.18802)
- Creative Commons Attribution 4.0
- OpenAI API reference: create speech
- TRON developer hub: TRC-20
- W3C WAI: making audio and video accessible
- curl documentation
- Node.js documentation
- Python documentation
